ChatGPT에 질문하면 설명부터 번역, 코드 작성까지 자연스러운 답변이 돌아옵니다. 컴퓨터는 숫자를 계산하는 기계인데, 어떻게 문장의 의미와 대화의 흐름을 다룰 수 있을까요?
핵심은 언어를 숫자로 표현하고, 문맥 속 관계를 계산하며, 그다음에 이어질 토큰을 생성하는 과정입니다. 아래에서는 GPT 계열 언어 모델의 텍스트 처리 원리를 단순화해 살펴보겠습니다.
1. 문장을 작은 조각, 토큰으로 나눈다
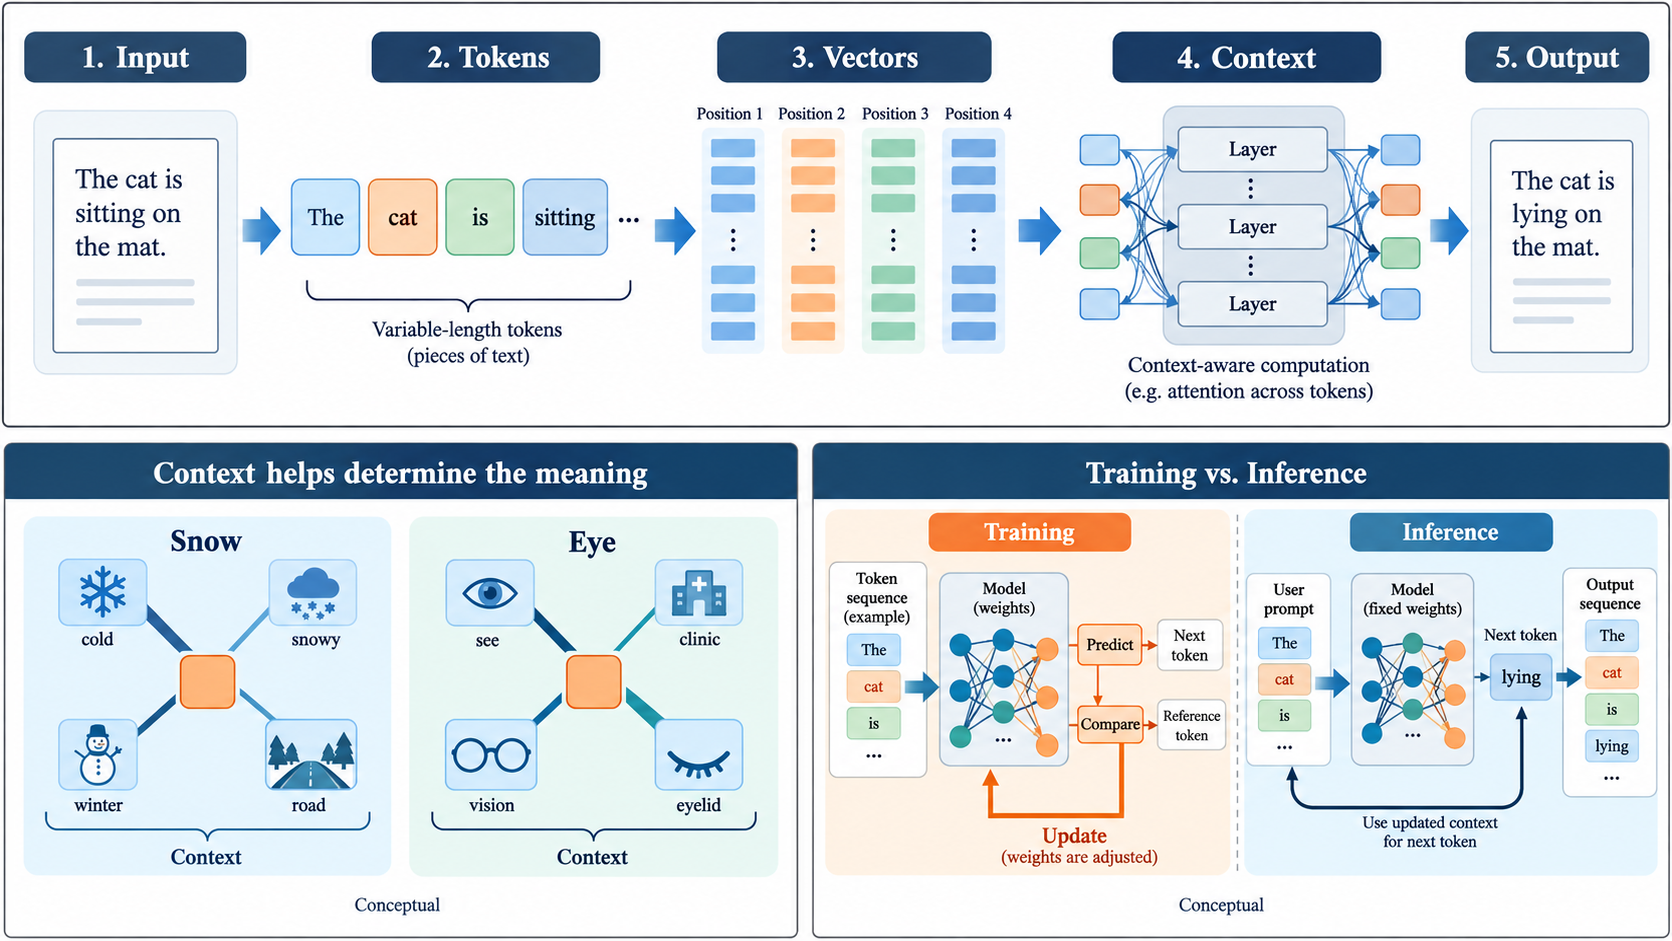
모델은 입력 문장을 토큰(Token)이라는 단위로 처리합니다. 토큰은 단어 하나일 수도 있고, 단어의 일부나 문장부호일 수도 있습니다. 따라서 한글 한 글자나 단어 하나가 항상 토큰 하나에 대응하지는 않습니다. 분할 방식은 사용하는 토크나이저에 따라 달라집니다. OpenAI: 토큰 설명
각 토큰에는 ID가 붙고, 모델 내부에서는 임베딩(Embedding)이라는 숫자 벡터로 표현됩니다. 문장 속 위치 정보도 함께 반영됩니다. 이 표현이 여러 신경망 층을 통과하면서 주변 토큰과의 관계를 담은 표현으로 바뀝니다.
입력 문장 → 토큰 → 숫자 표현 → 문맥 계산 → 답변 생성
2. Attention으로 주변 표현의 관계를 계산한다
다음 두 문장을 보겠습니다.
- “눈이 많이 내려 도로가 미끄럽다.”
- “눈이 아파서 안과에 갔다.”
같은 ‘눈’이라도 주변의 ‘내려’, ‘도로’와 ‘아파서’, ‘안과’가 가리키는 의미는 다릅니다.
트랜스포머(Transformer)의 핵심 요소인 셀프 어텐션(Self-Attention)은 토큰 사이의 관련성을 계산하고, 다른 토큰의 정보를 서로 다른 가중치로 반영합니다. 위 예시에서는 주변 표현이 ‘눈’의 문맥상 의미를 구분하는 단서가 됩니다.
Attention과 신경망의 여러 층을 거치며 이런 관계를 반복해서 계산하기 때문에, 떨어져 있는 표현의 연결이나 문장 전체의 맥락도 다룰 수 있습니다. 다만 Attention의 가중치만으로 모델의 판단 이유 전체를 설명할 수 있는 것은 아닙니다. OpenAI: Attention과 토큰 표현
3. 답변하는 능력은 학습으로 만들어진다
이 계산이 유용하려면 신경망 안의 가중치(Weight)가 적절하게 조정되어 있어야 합니다.
언어 모델의 대표적인 사전학습(Pre-training) 방식은 앞선 문맥에서 다음 토큰을 예측하고, 실제 데이터와의 차이를 줄이도록 가중치를 조정하는 것입니다. 이 과정을 반복하면서 문법, 표현의 연결, 여러 지식과 문제 해결 패턴을 학습합니다.
이후에는 바람직한 응답 예시나 응답에 대한 선호·평가를 활용하는 후속학습(Post-training)을 적용할 수 있습니다. 질문에 맞는 형식과 설명 방식으로 답하도록 행동을 조정하는 과정입니다. 구체적인 학습 구성은 모델마다 다릅니다. OpenAI: 모델 학습과 응답 최적화
학습은 가중치를 조정하는 과정이고, 추론(Inference)은 학습된 모델로 입력을 처리해 결과를 만드는 과정입니다. 대화에 맞게 답변이 달라지는 현상과 모델을 다시 학습시키는 일은 구분해야 합니다.
4. 답변은 다음 토큰을 이어 붙이며 만들어진다
질문이 들어오면 모델은 제공된 문맥을 바탕으로 다음 토큰 후보들의 확률을 계산합니다.
P(다음 토큰 | 입력 문맥, 지금까지 생성한 토큰)
여기서 토큰 하나를 선택하고, 그 토큰까지 포함한 문맥으로 다음 토큰을 다시 계산합니다. 이 과정을 반복하면 문장과 문단이 만들어집니다.
매번 확률이 가장 높은 토큰만 선택하는 것은 아닙니다. 선택 방식과 설정에 따라 다른 후보를 고를 수 있어 같은 질문에도 표현이 달라질 수 있습니다. 또한 토큰의 생성 확률은 그 문장이 사실일 확률과 다릅니다. OpenAI: 문맥에 따른 토큰 확률
5. 앞선 대화는 어떻게 반영할까?
“MOSFET을 설명해줘”라고 물은 뒤 “그럼 Gate 전압을 높이면?”이라고 이어 물을 수 있습니다. 앞선 질문과 답변이 현재 입력 문맥에 포함되면, 모델은 생략된 대상을 연결해 답변할 수 있습니다.
한 번의 처리에서 사용할 수 있는 토큰 범위를 컨텍스트 윈도(Context Window)라고 합니다. 이 범위에는 한계가 있어 긴 대화의 모든 내용이 언제나 그대로 반영된다고 가정해서는 안 됩니다. OpenAI: 대화 문맥과 처리 범위
6. 자연스럽게 답하면서도 틀리는 이유
문장이 자연스럽다는 것과 내용이 검증되었다는 것은 다릅니다. 언어 모델은 근거가 부족한 상황에서도 그럴듯한 설명이나 존재하지 않는 정보를 생성할 수 있습니다. 이를 환각(Hallucination)이라고 부릅니다.
그래서 실제 문서나 지식베이스와 응답을 대조하고, 문장별 사실성과 전체 문맥을 확인하는 검증이 필요합니다. 자료를 제공해도 오류 가능성이 완전히 없어지는 것은 아닙니다. OpenAI: 응답의 사실성과 근거 확인
예를 들어 설계 매뉴얼을 설명받을 때는 원문과 파라미터 표를 함께 제공하고, “문서에서 확인한 내용과 추정한 내용을 구분해줘”라고 요청할 수 있습니다. 무엇을 설명해야 하는지와 근거가 무엇인지 구체적으로 전달하는 방식입니다.
ChatGPT를 활용할 때는 문맥을 다루고 답변을 생성하는 능력과 답변의 사실성을 확인하는 절차를 함께 생각하면 좋습니다. 질문의 대상과 목적, 참고 자료를 분명히 줄수록 결과를 이해하고 검토하기도 쉬워집니다.


댓글