존재하지 않는 논문 제목을 그럴듯하게 소개하거나, 매뉴얼에 없는 기본값을 단정하는 답변을 본 적이 있을 것입니다.
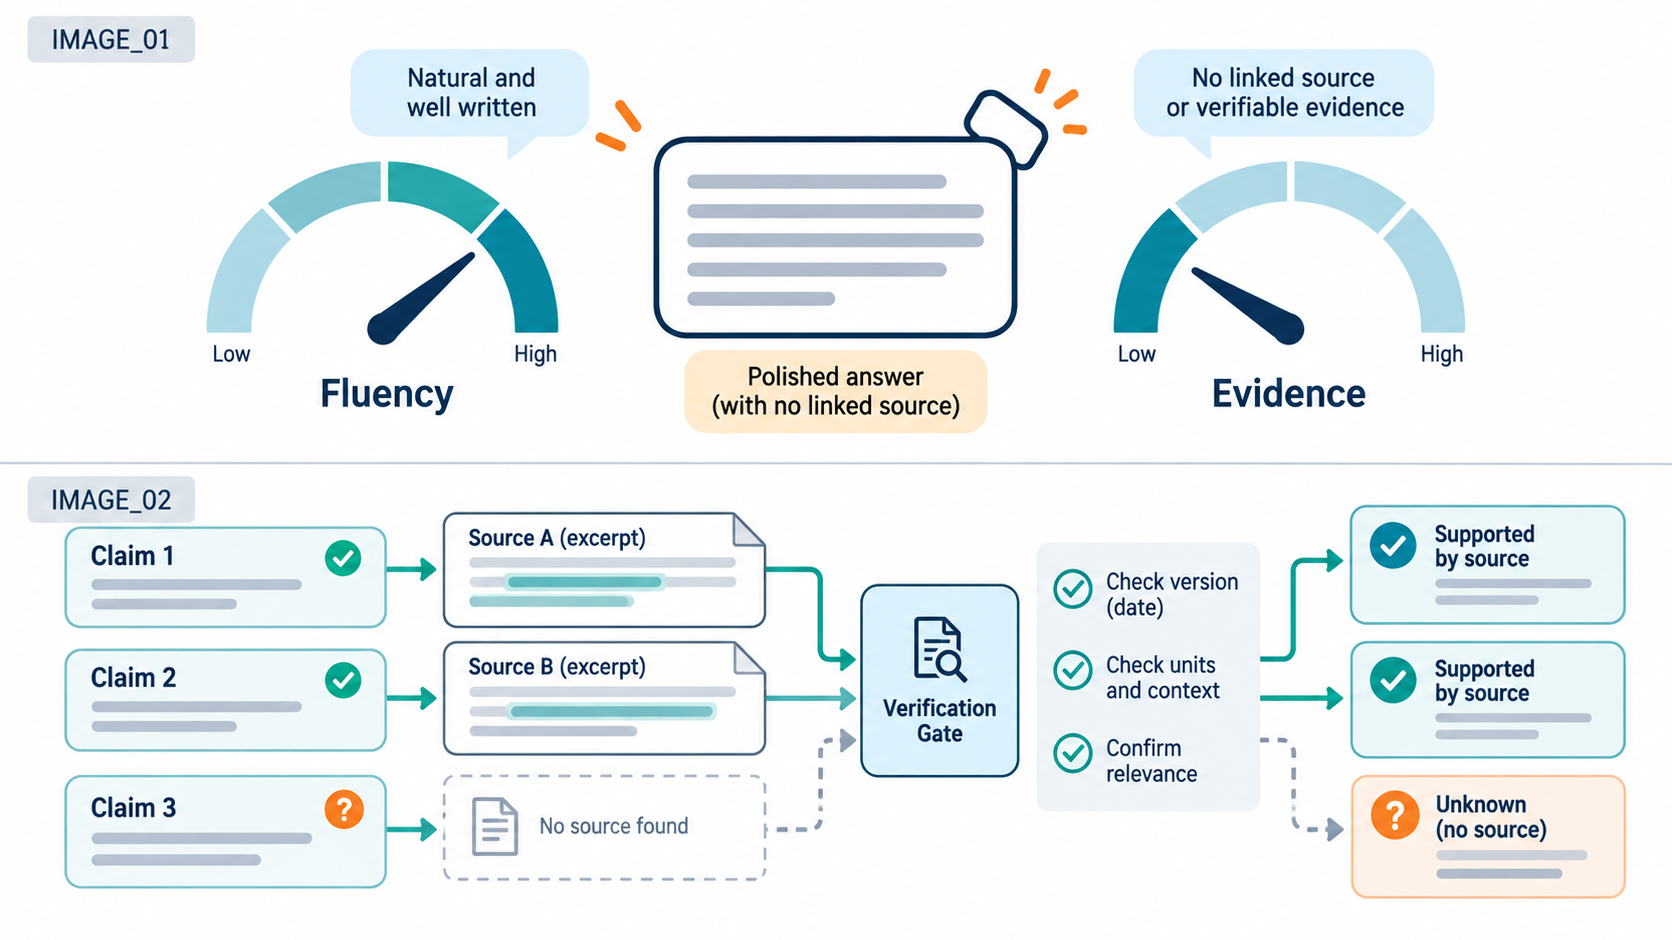
Hallucination은 사실과 다르거나 주어진 근거가 뒷받침하지 않는 내용을 사실처럼 생성하는 현상입니다. 유창한 문체는 읽기 편하게 해주지만, 그 내용의 정확성을 보증하지는 않습니다.
1. 토큰 확률은 사실일 확률이 아니다
언어 모델은 문맥에 이어질 표현을 생성합니다. 어떤 단어가 자연스러운 다음 표현인지와, 그 단어가 포함된 주장이 현실에서 참인지는 다른 문제입니다.
예를 들어 “이 함수의 기본 단위는” 다음에 익숙한 단위 표현이 나올 수 있습니다. 하지만 실제 사내 함수가 어떤 단위를 쓰는지는 원문이나 시험 결과로 확인해야 합니다. 자연스러움만으로 빈칸을 채우면 잘못된 설명이 만들어집니다.
2. 원인을 하나로 설명하기 어렵다
학습 데이터의 오류·불균형, 드문 사실에 대한 정보 부족, 오래된 정보, 모호한 질문, 검색 실패, 문맥을 잘못 사용하는 문제가 함께 작용할 수 있습니다. “데이터가 틀려서만” 혹은 “무조건 확률적으로 생성해서만” 생기는 현상으로 줄이면 대응 방법도 좁아집니다.
학습과 평가에서 불확실성을 인정하는 응답보다 추측해서 맞히는 응답이 유리해질 수 있다는 분석도 있습니다. 이는 가능한 원인과 유인을 설명하는 연구 관점이며 모든 오류를 하나의 법칙으로 설명한다는 뜻은 아닙니다. 학습·평가 유인에 관한 분석
3. 자신 있는 말투는 내부 확신의 계기판이 아니다
“확실합니다”라는 표현이 나온다고 해서 별도의 사실 검증기가 승인한 것은 아닙니다. 반대로 “아마도”라는 말이 붙었다고 오류 가능성이 잘 보정되어 있다고 볼 수도 없습니다.
사용자가 요구하는 단정적인 형식, 익숙한 설명 패턴, 불충분한 근거가 결합해 자신 있는 오답이 만들어질 수 있습니다. 따라서 문체와 내용의 근거를 분리해서 읽는 습관이 필요합니다.
4. RAG와 자기검토가 도와도 보장은 아니다
관련 문서를 검색해 넣으면 실제 자료를 참조할 기회가 생깁니다. 그러나 잘못된 버전을 검색하거나, 문서의 예외 조건을 빠뜨리거나, 출처가 말하지 않은 내용을 덧붙일 수 있습니다.
모델에게 자기검토를 요청하는 것도 보완 수단입니다. 같은 잘못된 전제를 그대로 사용하면 검토 결과 역시 틀릴 수 있으므로, 가능한 부분은 원문 대조나 계산·테스트로 확인해야 합니다. 주장별 근거를 검사하는 방법
5. 업무에서는 무엇을 남겨야 할까?
설계 문서를 설명하는 예라면 입력값, 단위, 기본식, 적용 조건에 각각 근거 위치를 연결할 수 있습니다. 코드에서 확인한 사실과 담당자가 제공한 정보, 추론과 미확인을 나눠 저장하면 검토가 쉬워집니다.
답변의 “근거 없음” 표시도 중요합니다. 답을 못한 비율만 줄이려고 하면 정보가 부족한 질문에 억지로 답할 수 있습니다. 정답률과 함께 잘못된 단정, 적절한 보류, 실제 인용 일치 여부를 평가해야 합니다.
사용자는 “자료에서 확인한 내용만 설명하고, 없는 정보는 미확인으로 남겨줘”라고 요청할 수 있습니다. 다만 이 문장 자체가 검증 프로그램을 대신하지는 않습니다.
LLM을 유용하게 쓰려면 유창함과 정확성을 따로 다뤄야 합니다. 중요한 주장의 출처를 확인하고, 정보가 없을 때 멈출 수 있게 만드는 구조가 답변의 신뢰성을 높이는 출발점입니다.
'기억하고 싶은 지식 > 인공지능' 카테고리의 다른 글
| [전자/인공지능] Embedding이란 무엇인가? 단어를 벡터로 표현하는 원리 (0) | 2026.10.25 |
|---|---|
| [전자/인공지능] LLM의 추론(Reasoning)은 일반적인 답변 생성과 무엇이 다를까?' (0) | 2026.10.25 |
| [전자/인공지능] AI Agent란 무엇인가? ChatGPT와 자율형 AI의 차이 (1) | 2026.10.24 |
| [전자/인공지능] RAG란 무엇인가? LLM이 외부 문서를 검색하고 답변하는 원리 (0) | 2026.10.24 |
| [전자/인공지능] Transformer란 무엇인가? LLM의 핵심 구조 이해하기 (0) | 2026.10.23 |


댓글