“소자 간격을 바꾸고 싶다”는 질문으로 “instance pitch 설정”이라는 문서를 찾으려면 단어가 정확히 같지 않아도 관계를 계산할 수 있어야 합니다. 이때 자주 등장하는 표현이 Embedding입니다.
Embedding은 단어나 문장 같은 데이터를 숫자 벡터로 표현하는 방법입니다. 벡터는 여러 숫자를 순서대로 모은 것으로, 모델이 학습한 기준에 따라 데이터의 관계를 계산하는 데 사용됩니다.
1. ID를 붙이는 일과 의미를 표현하는 일
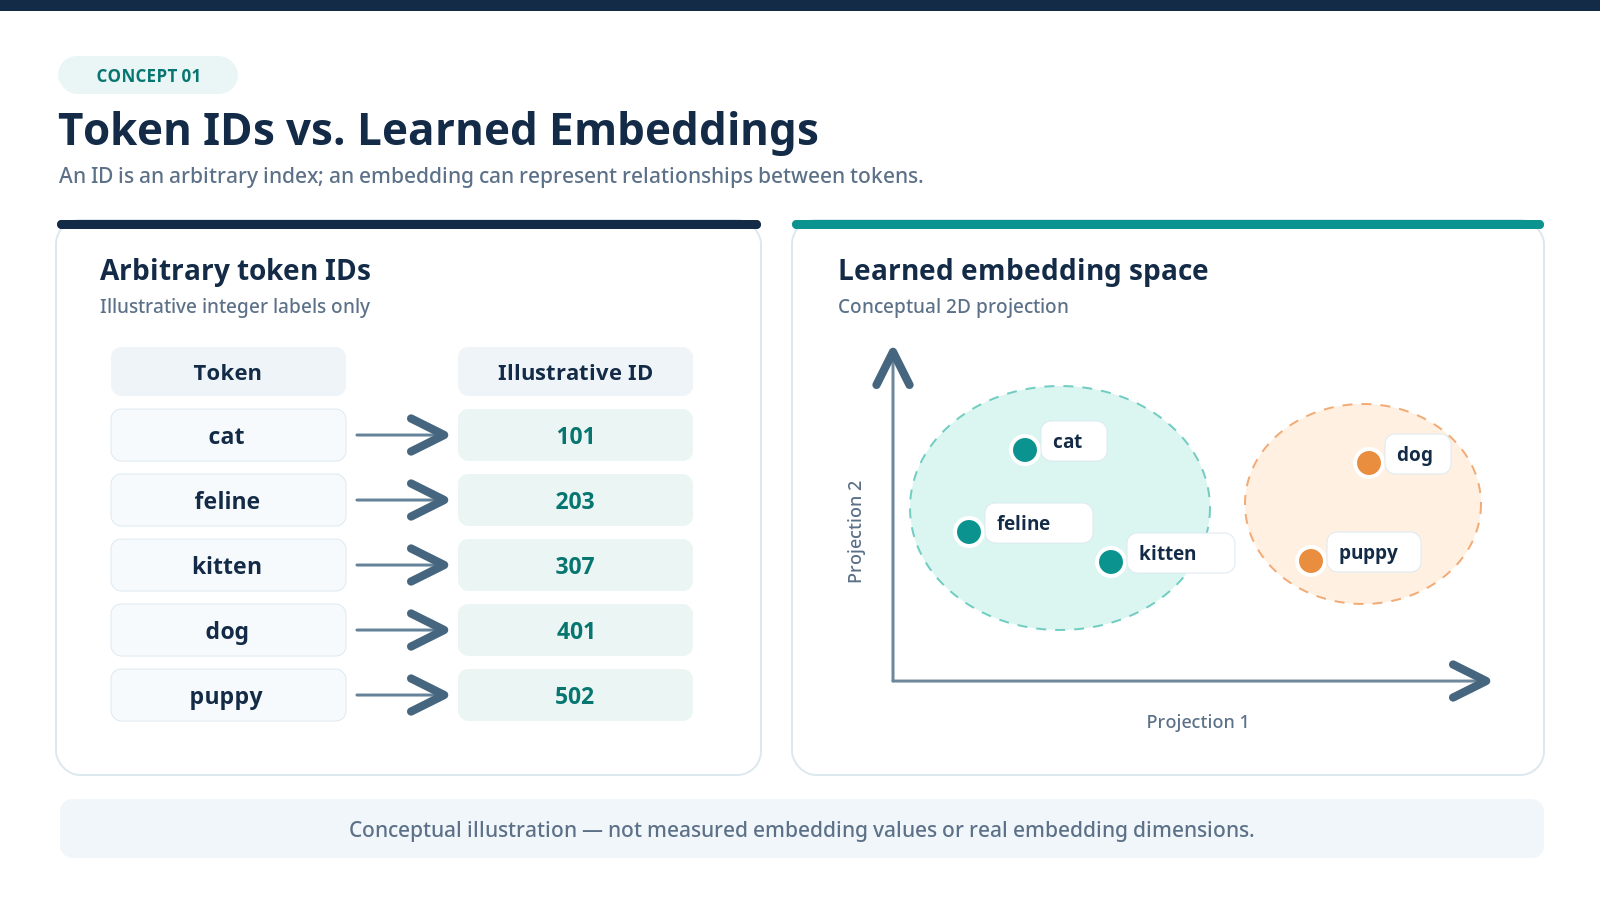
단어마다 1번, 2번, 3번이라는 ID를 붙이는 것만으로는 의미가 가까운지 알기 어렵습니다. ID의 크기 차이가 실제 뜻의 차이를 나타내지는 않기 때문입니다.
Embedding에서는 학습을 통해 여러 차원의 숫자 표현을 만듭니다. 검색용 모델은 관련 있는 질문·문장 표현이 가깝게 배치되도록 학습될 수 있습니다. 다만 각 차원이 항상 “크기”, “온도”, “긍정성”처럼 사람이 해석할 수 있는 속성에 대응하는 것은 아닙니다. 벡터 표현과 활용
2. 단어 임베딩과 문장 임베딩은 다르다
전통적인 단어 임베딩은 같은 단어에 고정된 벡터를 부여하는 방식이 대표적입니다. 문맥을 반영하는 모델에서는 같은 토큰도 주변 표현과 층에 따라 내부 표현이 달라집니다.
문장 임베딩은 문장이나 문서 조각 전체를 비교 가능한 벡터로 압축합니다. 언어 모델 내부의 토큰 표현과 검색 전용 문장 임베딩을 동일한 결과물로 보면 안 됩니다. 검색 목적에 적합하게 학습된 모델과 문장 표현 방법이 필요합니다.
3. 벡터 사이의 관련성은 어떻게 계산할까?
널리 사용하는 방법 중 하나는 코사인 유사도(Cosine Similarity)입니다.
cosine(a, b) = (a · b) / (|a| × |b|)
두 벡터의 방향이 얼마나 비슷한지 계산하는 식입니다. 여기서 점은 내적, |a|와 |b|는 각 벡터의 길이입니다. 영벡터에는 이 식을 그대로 적용할 수 없습니다. 문장 유사도 계산
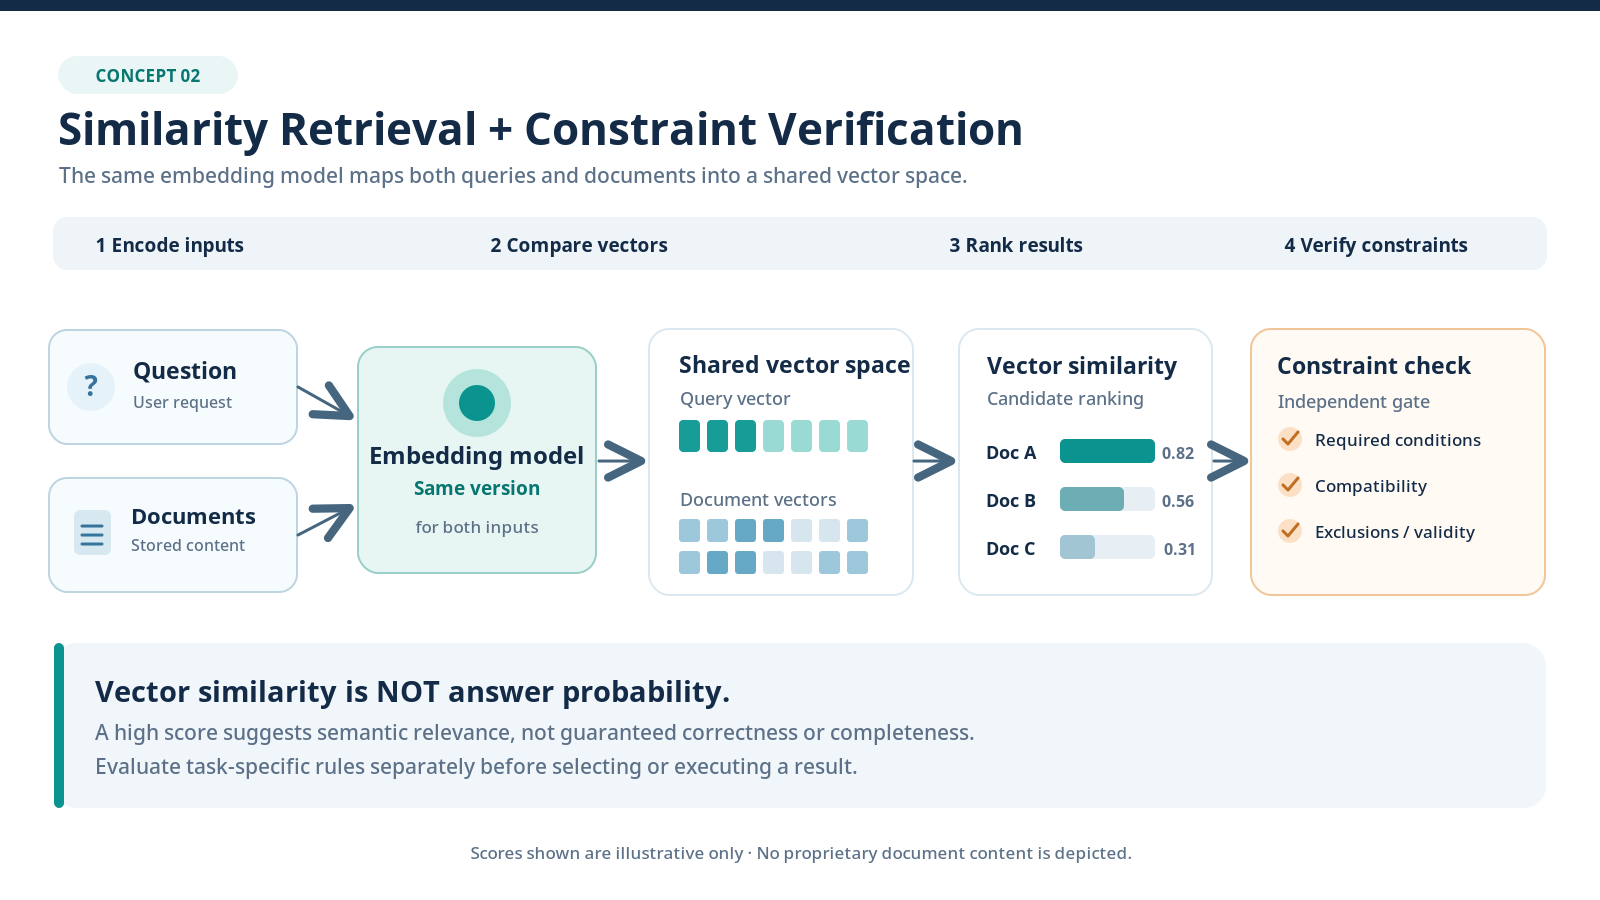
모델과 거리 함수가 달라지면 점수의 의미도 달라집니다. 예를 들어 0.8이라는 값이 나왔다고 “정답일 확률 80%”로 읽을 수는 없습니다. 실제 관련 여부를 라벨링한 데이터로 판단 기준을 정해야 합니다.
4. 검색에서 중요한 일치 조건
문서와 질문은 같은 임베딩 공간에서 비교해야 합니다. 서로 다른 모델의 벡터를 차원이 같다는 이유만으로 섞으면 올바른 관계를 기대할 수 없습니다.
모델 버전, 전처리, 질문·문서용 입력 형식도 함께 관리해야 합니다. 검색 모델을 교체하면 문서 벡터를 다시 계산하고 검색 결과를 검증하는 과정이 필요할 수 있습니다. 저장된 벡터 옆에 원문과 출처를 남기는 이유도 여기에 있습니다.
5. 의미가 가깝다고 업무 조건까지 같은 것은 아니다
“배선 생성”과 “배선 삭제 금지”는 비슷한 단어를 많이 공유하지만 요구 동작은 다릅니다. 임베딩 검색 결과에는 이런 후보가 함께 들어올 수 있습니다.
따라서 정확한 함수명은 키워드 검색으로 보완하고, 생성·수정·삭제 같은 동작과 필수 조건은 별도로 비교하는 편이 좋습니다. 검색 유사도가 실제 기능 적합성을 대신하지 않기 때문입니다.
Embedding은 언어를 완벽하게 숫자로 번역하는 사전이 아닙니다. 학습한 목적에 맞춰 데이터 사이의 관계를 계산할 수 있는 표현이며, 어떤 모델과 비교 기준을 쓰느냐에 따라 검색의 성격도 달라집니다.
'기억하고 싶은 지식 > 인공지능' 카테고리의 다른 글
| [전자/인공지능] LLM의 추론(Reasoning)은 일반적인 답변 생성과 무엇이 다를까?' (0) | 2026.10.25 |
|---|---|
| [전자/인공지능] AI Agent란 무엇인가? ChatGPT와 자율형 AI의 차이 (1) | 2026.10.24 |
| [전자/인공지능] RAG란 무엇인가? LLM이 외부 문서를 검색하고 답변하는 원리 (0) | 2026.10.24 |
| [전자/인공지능] Transformer란 무엇인가? LLM의 핵심 구조 이해하기 (0) | 2026.10.23 |
| [전자/인공지능] ChatGPT는 어떻게 사람의 언어를 이해하고 답변할까?" (1) | 2026.10.22 |


댓글