같은 모델의 답변이 달라지는 이유를 살펴보는 리멤버미입니다. 문서 요약은 일관되게, 아이디어 목록은 다양하게 만들고 싶을 때 Temperature와 Top-p를 조정하라는 설명을 자주 보게 됩니다.
Temperature는 다음 토큰의 확률분포를 조정하고, Top-p는 샘플링에 포함할 후보 집합을 누적확률로 제한합니다. 둘 다 모델의 지식을 다시 학습시키는 설정은 아닙니다.
1. Temperature는 확률분포를 얼마나 뾰족하게 할지 정한다
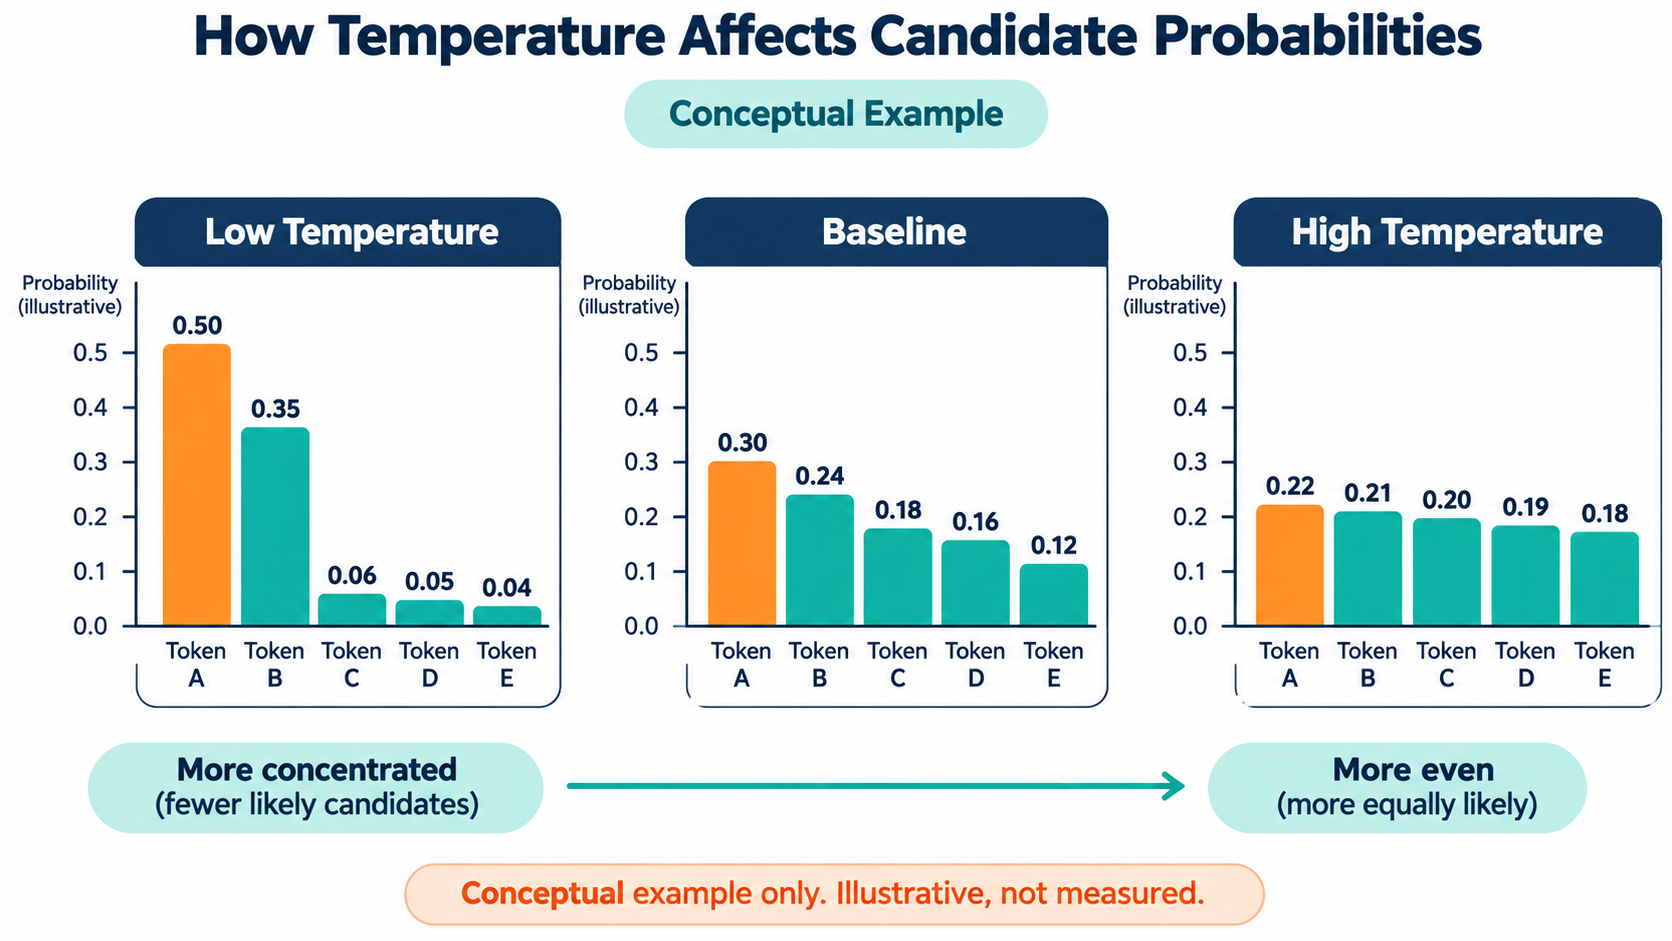
모델이 출력하는 후보별 점수를 Logit이라고 합니다. T가 양수일 때 Temperature 적용은 다음처럼 나타낼 수 있습니다.
pᵢ = exp(zᵢ / T) / Σⱼ exp(zⱼ / T)
zᵢ는 후보 i의 점수입니다. T가 낮아지면 점수가 높은 후보에 확률이 더 집중되고, 높아지면 분포가 상대적으로 평평해집니다. 그러나 T를 높였다고 모든 후보가 같은 확률이 되는 것은 아닙니다. Temperature와 샘플링
2. Top-p는 후보 수를 고정하지 않는다
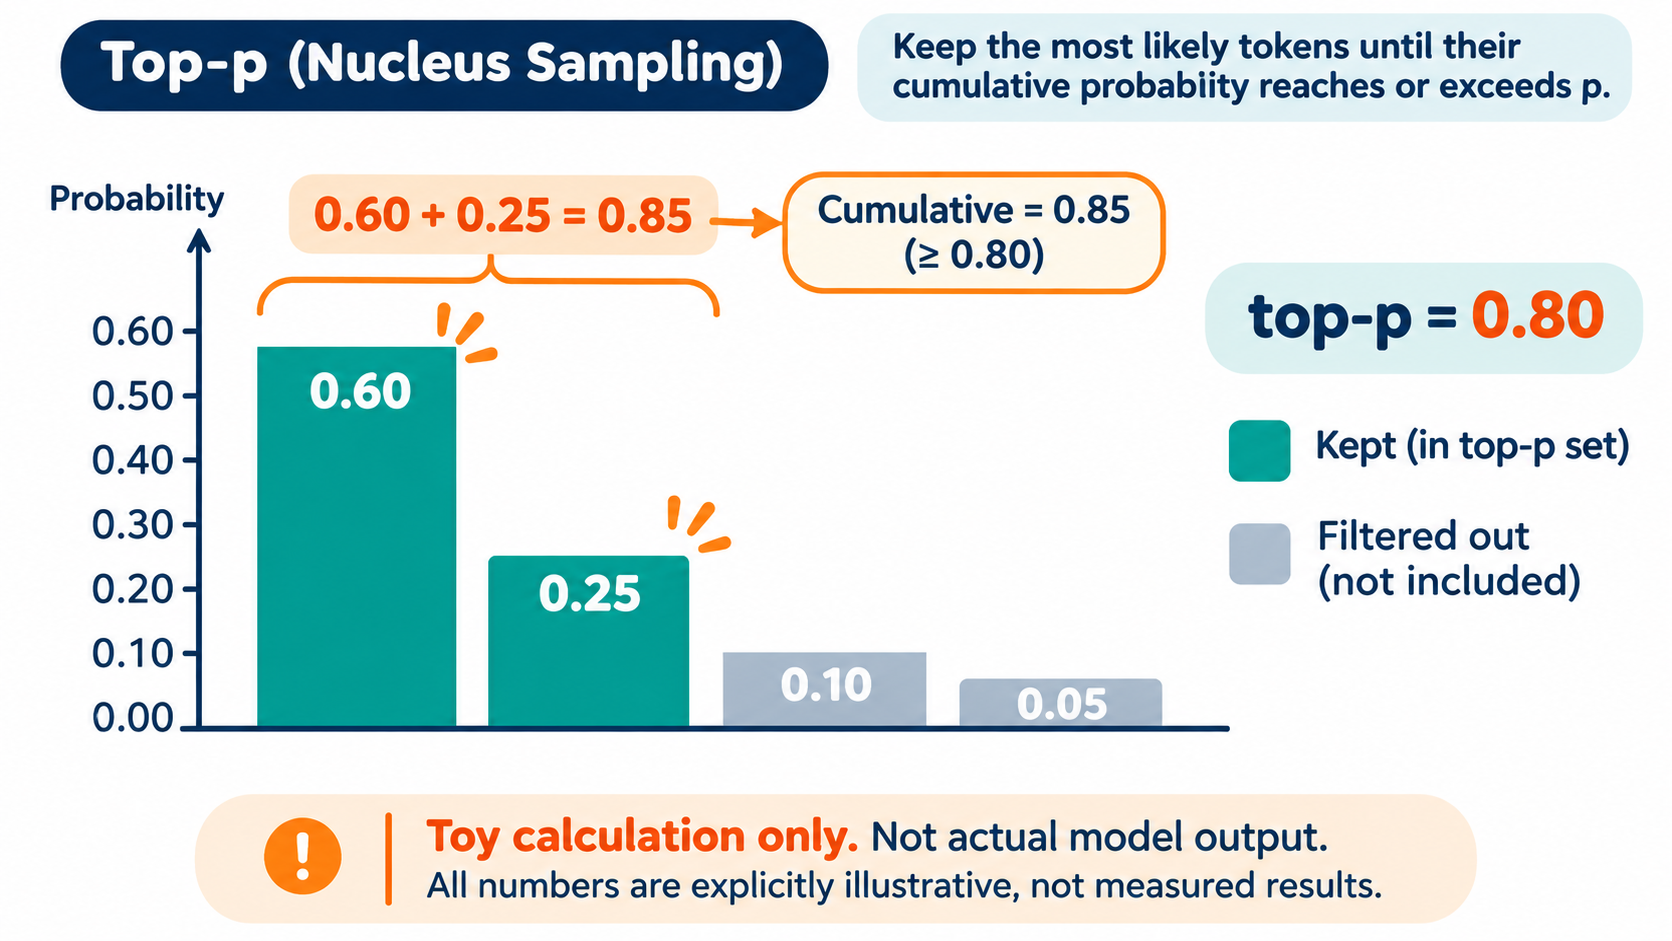
Top-p는 Nucleus Sampling이라고도 부릅니다. 확률이 큰 순서로 후보를 모아 누적확률이 p 이상이 되는 최소 집합을 남기고, 그 안에서 다시 확률을 정규화해 선택합니다.
설명용 분포가 0.60, 0.25, 0.10, 0.05이고 Top-p가 0.8이라면 첫 두 후보의 합인 0.85가 기준을 넘으므로 두 후보를 남깁니다. 이 숫자는 실제 모델 출력이 아닌 계산 예시입니다.
분포가 뾰족하면 적은 후보가, 평평하면 더 많은 후보가 남을 수 있습니다. 후보 개수를 정하는 Top-k와 이 점이 다릅니다. 생성 설정의 정의
3. 두 설정은 같은 조절기가 아니다
Temperature는 상대 확률을 바꾸고, Top-p는 낮은 확률의 꼬리 부분을 잘라 후보 범위를 제한합니다. 함께 쓰면 분포 조정과 후보 제한이 서로 영향을 줄 수 있습니다.
적용 순서와 다른 필터의 조합은 구현에 따라 확인해야 합니다. Greedy Decoding처럼 샘플링을 하지 않는 모드에서는 해당 설정이 적용되지 않거나 의미가 달라질 수 있습니다. API가 인자를 받는다고 모든 모델과 모드에서 같은 동작을 보장하는 것은 아닙니다.
4. 낮은 Temperature가 정답을 보장할까?
답변 표현의 다양성을 줄이는 것과 사실 오류를 없애는 것은 다릅니다. 모델이 가장 높은 점수를 준 후보 자체가 틀린 설명으로 이어질 수 있기 때문입니다.
Temperature 0을 지원하는 인터페이스도 있지만, 이를 앞의 식에 그대로 대입해서는 안 됩니다. 보통 별도 선택 방식으로 처리하며 정확한 의미는 구현을 따라야 합니다. 또한 하드웨어·서버·모델 설정 때문에 완전히 동일한 문자열이 항상 재현된다고 단정할 수 없습니다.
5. 업무에 맞게 하나씩 비교한다
일관된 형식의 데이터 추출이라면 정확한 출력 규격과 입력 근거를 먼저 준비해야 합니다. 설정만 낮추는 것으로 누락된 자료나 모호한 지시가 해결되지는 않습니다.
여러 아이디어를 탐색할 때는 다양성이 도움이 될 수 있지만, 유효한 후보 비율도 함께 확인해야 합니다. 같은 질문 집합에서 한 설정씩 바꿔 답변의 차이, 사실성, 중복, 형식 준수 여부를 기록하는 편이 좋습니다.
Temperature와 Top-p는 창의성이나 지능을 직접 정하는 수치가 아닙니다. 이미 계산된 후보를 어떤 분포와 범위에서 선택할 것인지를 조절하는 도구로 이해하면 과도한 기대를 줄일 수 있습니다.
'기억하고 싶은 지식 > 인공지능' 카테고리의 다른 글
| [전자/인공지능] ChatGPT는 왜 틀린 답을 자신 있게 말할까? Hallucination의 원인 (1) | 2026.10.25 |
|---|---|
| [전자/인공지능] Embedding이란 무엇인가? 단어를 벡터로 표현하는 원리 (0) | 2026.10.25 |
| [전자/인공지능] LLM의 추론(Reasoning)은 일반적인 답변 생성과 무엇이 다를까?' (0) | 2026.10.25 |
| [전자/인공지능] AI Agent란 무엇인가? ChatGPT와 자율형 AI의 차이 (1) | 2026.10.24 |
| [전자/인공지능] RAG란 무엇인가? LLM이 외부 문서를 검색하고 답변하는 원리 (0) | 2026.10.24 |


댓글